
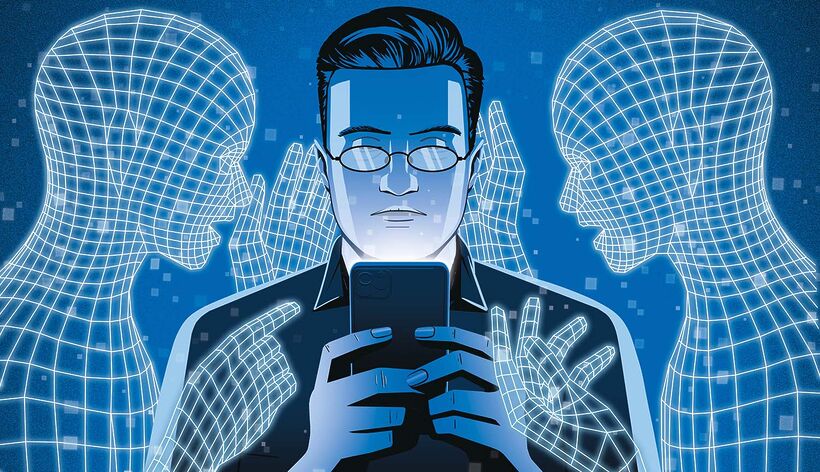
В эпоху эпидемии онлайн-дезинформации, поразившей социальные сети и мессенджеры, эксперты все чаще обращают свой взор к искусственному интеллекту в надежде, что машины помогут отделить факты от вымысла. Парадокс ситуации трудно не заметить: именно технологии ИИ, генерирующие дипфейки и лавины правдоподобного текста, во многом и раздули пожар, который теперь предстоит тушить с их же помощью.
Современные системы проверки фактов уже не справляются в одиночку: объем производимого контента растет экспоненциально, а скорость распространения вирусных фальшивок многократно опережает возможность редактора-человека выпить утренний кофе. По данным исследователей из Массачусетского технологического института, ложная новость в Twitter распространяется в шесть раз быстрее правдивой и охватывает значительно более широкую аудиторию — в первую очередь потому, что она эмоциональнее, сенсационнее и лучше сконструирована для нажатия на человеческие страхи и гнев.
Как машины учатся чуять ложь
Разработчики делают ставку на несколько направлений. Первое — это большие языковые модели (LLM), обученные на гигантских массивах проверенной информации. ИИ сканирует текст новости, сопоставляет утверждения с авторитетными базами данных, научными публикациями и официальными отчетами, подсвечивая расхождения за секунды. Второе направление — анализ паттернов распространения: алгоритмы отслеживают, как именно новость пересылается, с каких аккаунтов стартует, не вовлечены ли в процесс бот-сети, координирующие вброс.
Третье, наиболее сложное, — мультимодальная верификация. Искусственный интеллект учится одновременно анализировать текст, изображение и аудиодорожку, выискивая микроскопические несоответствия: неестественное движение губ на видео, несовпадение теней, артефакты сшивки кадров. Именно на этом поле идет гонка вооружений между создателями дипфейков и их охотниками.
Почему технология — лишь половина ответа
Однако эксперты предостерегают от технооптимизма. Самая умная модель бессильна, если аудитория не желает слышать правду. Психологи уже описали феномен «эхо-камер» и когнитивного диссонанса: когда фактчекинг противоречит устоявшимся убеждениям человека, мозг склонен отторгать источник информации, а не пересматривать картину мира. Иными словами, можно создать идеальный детектор лжи, но люди попросту откажутся в него верить.
Кроме того, алгоритмы фактчекинга сами не застрахованы от предвзятости: они обучаются на текстах, написанных людьми с их культурными и политическими слепыми зонами. Если тренировочные данные смещены, ИИ может систематически ошибаться в спорных и пограничных случаях, принимая точку зрения большинства за объективную истину.
На пути к информационной гигиене
Ведущие технологические компании и новостные агентства уже встраивают ИИ-верификацию в свои платформы. Meta тестирует алгоритмы, помечающие подозрительные посты еще до того, как они наберут вирусный охват. Google разрабатывает инструменты, позволяющие пользователю видеть «историю» изображения: где оно впервые появилось, как видоизменялось и использовалось ли в других контекстах. Европейский Союз в рамках Акта о цифровых услугах (Digital Services Act) обязывает платформы внедрять прозрачные механизмы модерации контента, и без ИИ соблюсти эти требования технически невозможно.
Тем не менее, эксперты сходятся во мнении: искусственный интеллект не станет серебряной пулей. Без массового обучения цифровой грамотности, без воспитания привычки перепроверять источники и без ответственности платформ за алгоритмическое усиление сенсаций технологии рискуют остаться дорогим дополнением к информационной войне, а не лекарством от нее. Битва за правду в интернете только начинается, и ее исход зависит не только от кода, но и от готовности общества принять тот факт, что реальность сложнее одного вирусного заголовка.
Источники:
-
Vosoughi, S., Roy, D., & Aral, S. (2018). The spread of true and false news online. Science, 359(6380), 1146–1151.
-
European Commission, Digital Services Act (DSA), положения о прозрачности модерации контента, 2024.
-
MIT Technology Review, «How AI is changing fact-checking», 2025.
-
Google Research, About this image — инструмент верификации визуального контента, 2025.


Ваш комментарий